这篇是在 Hambook 的每日阅读里点开的。它讲的事情和这个博客一直在写的是同一件:不是在读得更多,而是在动手之前先想清楚。只是这里动手的对象换成了 AI。
原文是 Khalid ElGazzar 为 2026 年 6 月 30 日 AWS Egypt 线上 Meetup 写的回顾。直播用阿拉伯语,英文稿发在 DEV Community 的 AWS Community Builders 栏目。译文保留了原文的七个小节、六张插图和全部数字,去掉了那些指向作者其他文章的交叉链接;图片出自原文,图注是我加的。版权归原作者所有,原文地址:From Vibe Coding to Spec-Driven Development with Kiro IDE from AWS。
一、为什么这一场不用 vibe coding
大多数 AI 写代码的演示,还是同一个循环:写提示词,看结果,再写提示词。做个一次性脚本没问题。但只要需要 AI 把一整个系统装进脑子里——一个数据模型、五个 API 资源,以及它们之间的契约——这个循环立刻散架。
这场一小时免费线上分享的前提,就是给出另一个选择:规格驱动开发(spec-driven development,SDD)。在让 agent 写代码之前,先把「要做什么、怎么做」写下来。具体例子用 AWS 的 Kiro,要建的东西是 Anthropic 提出的开放协议 MCP(Model Context Protocol)。
二、用大白话说,什么是规格驱动开发
IBM 对规格驱动开发的定义是个好锚点:在开发开始之前,先写出并确认「要构建什么」的详细规格,让这份规格成为人和 AI agent 共同的单一事实来源。
IBM 把它描述成一个光谱,而不是一种固定做法:
- 规格先行(spec-first):为了开局清楚写一次,之后随代码演进而失效。适合小而短命的功能。
- 规格锚定(spec-anchored):规格随代码一起演进,通常由 CI/CD 里的测试来强制执行。多数团队的甜点区。
- 规格即源码(spec-as-source):规格本身就是事实来源,改规格就直接重新生成代码。高信任、高自动化,不适合心脏弱的人。
还有一个陷阱值得点名:把规格本身做过度。三周了还在争一个 JSON 字段该叫什么名字,规格就已经从省时间变成费时间。
这场分享给的经验法则是:打磨规格的成本,应该始终低于下游修误解的成本。这个关系一旦反过来,就停止打磨,开始写。
准备材料里还有一句很利落的总结:
AI 工程 ≈ 规格编码 + 护栏。
规格给 agent 明确的意图,护栏(测试、评审门禁、lint)让它不跑偏。
三、Kiro:AWS 对规格驱动开发的答案
Kiro 是 AWS 的 agentic IDE,基于 Code OSS,和 VS Code 同一个开源底座。规格流程是做进产品里的,不是外挂的一种提示词技巧。
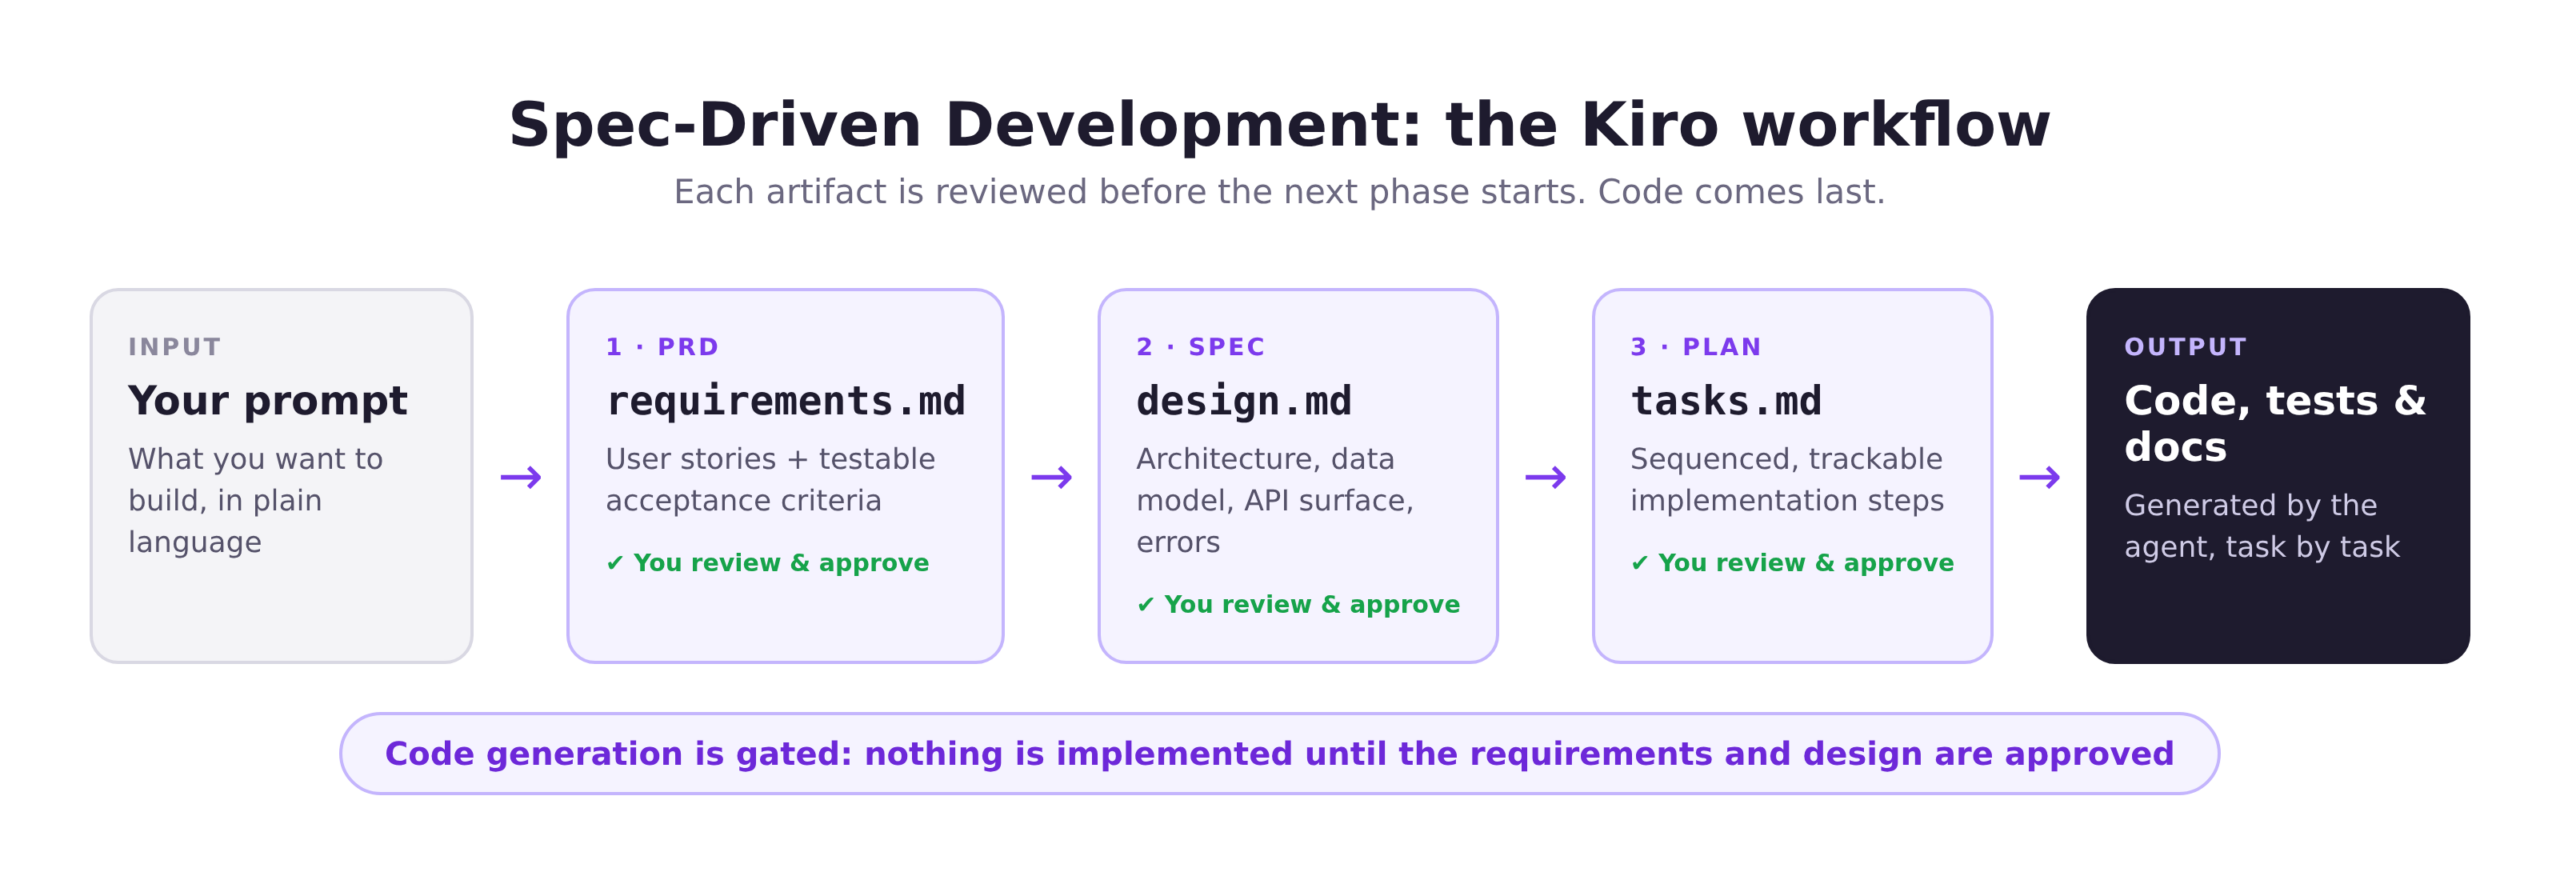
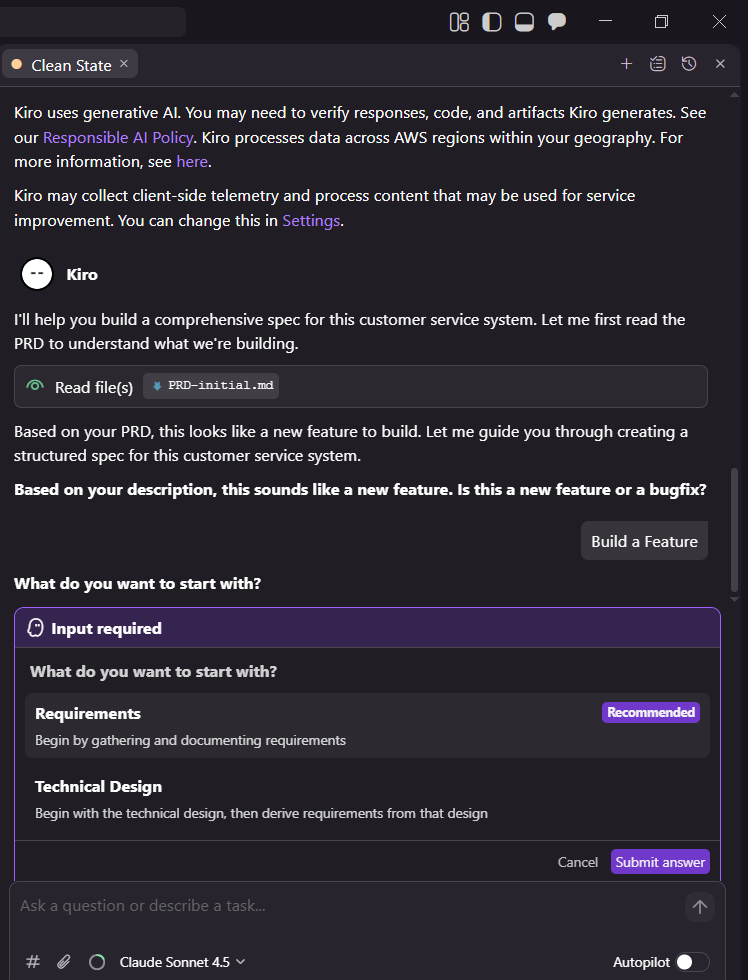
开一个功能,Kiro 按顺序产出三份文档。而且——这是结构上的关键——前两份你没有评审通过之前,它不会生成实现代码:
requirements.md,可以理解成 PRD:功能与非功能需求,用结构化的、可测试的语言写。验收标准用的是 EARS 记法。design.md,也就是 SPEC:架构,包括分层、数据模型、API 面、错误处理。tasks.md,也就是 PLAN:agent 真正要执行的有序、可追踪的实现步骤。
上手很简单:从 kiro.dev/downloads 下载对应系统的安装包,登录(AWS Builder ID 就行),首次启动可以导入现有的 VS Code 设置和扩展。评估时值得知道的几件事:
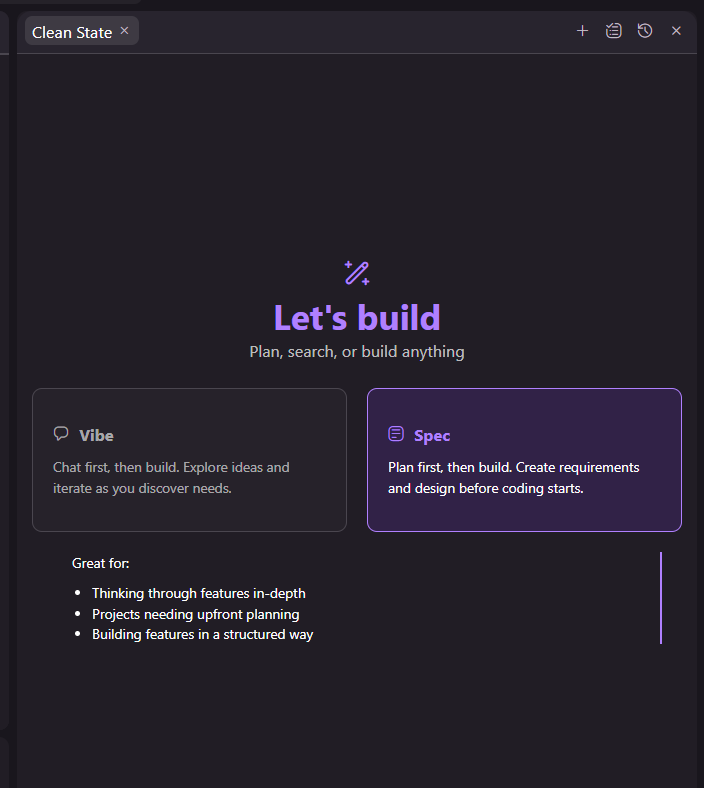
IDE 里「Vibe」和「Spec」两种模式是显式切换的。Kiro 不强制每一次按键都走规格,这是你为「值得结构化」的工作主动选的模式。
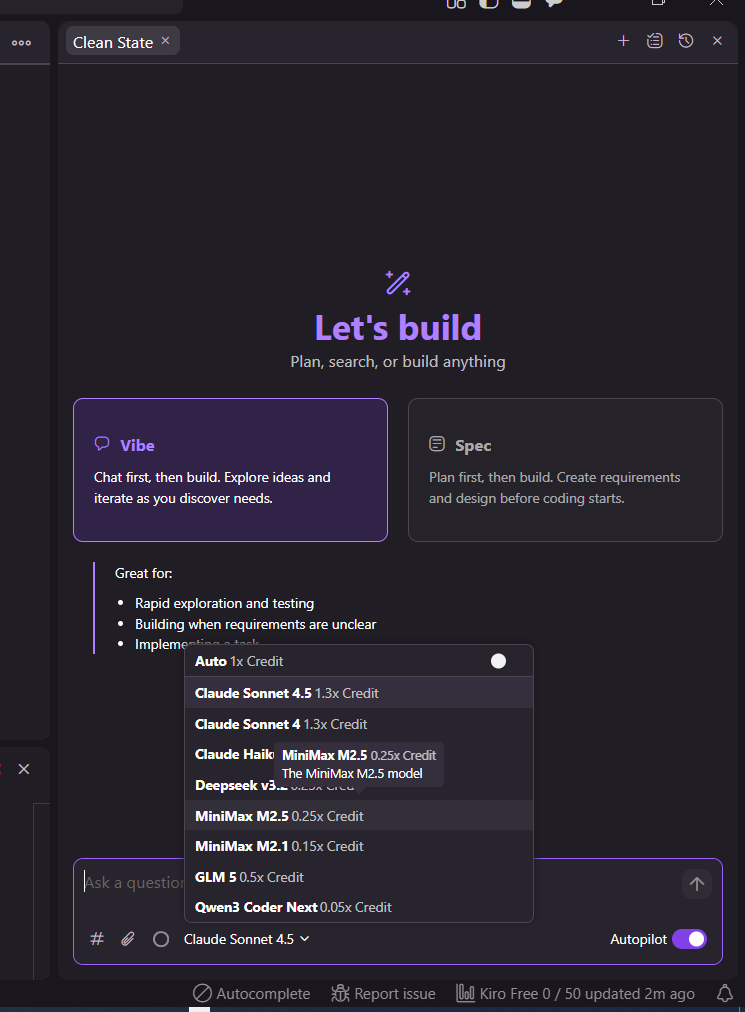
模型可以指定,也可以留在 Auto。每个模型有自己的 credit 倍率,开源权重模型每次请求明显更便宜。
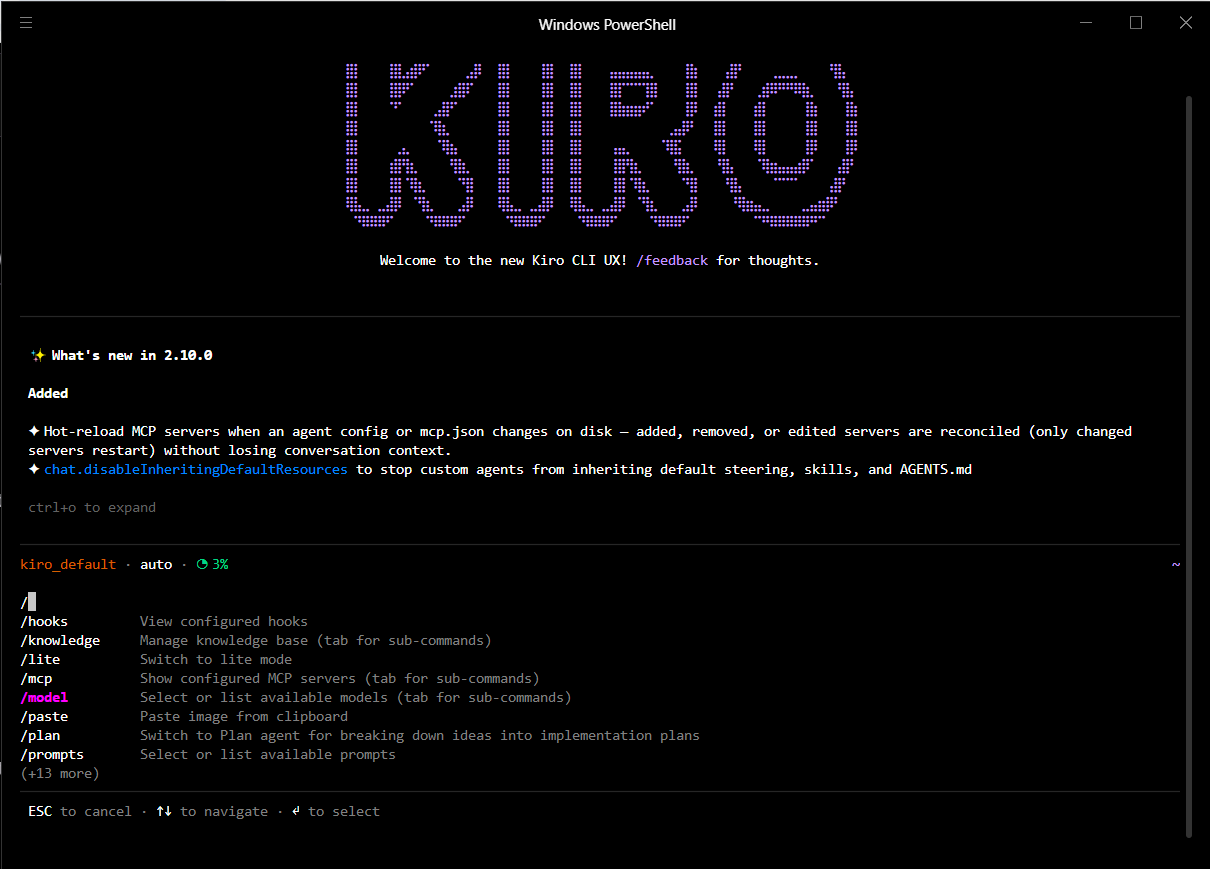
Kiro CLI 和 IDE 并存,斜杠命令的路子和 Claude Code、Codex CLI、GitHub Copilot CLI 一脉相承,规格流程不会被锁死在一个编辑器里。
定价动得很快。发布时三档,到 2026 年 6 月已经涨到五档。这种细节最容易过期,直接查 kiro.dev/pricing。
想要更多背景,这场分享主要靠两份材料:上面 IBM 那篇,以及 Birgitta Böckeler 在 martinfowler.com 上对 Kiro、spec-kit、Tessl 三个工具的比较。
四、现场构建:一个客服 MCP server
一小时的窗口里,demo 挑了一个刻意小、但真实的目标,拆成两个 sprint:
- Sprint 1:一个 Node.js REST API,跑在 SQLite 的客服库上(约 100 个客户,以及他们的购买、付款、客服交互历史),用 Swagger/OpenAPI 写全文档,能从 Postman 里测。
- Sprint 2:把同一个 service 层包成一个 MCP server,让 Claude Desktop 这类客户端可以用自然语言问「客服问题最多的是哪个客户」,答案来自真实数据库,不是猜的。
用 SQLite 而不用托管数据库,纯粹是为了让 demo 自包含。生产环境在 AWS 上怎么选,作者另有 DynamoDB 与 RDS 的专文。
交给 Kiro 的初始提示词几乎照抄准备笔记,要求它扮演资深软件架构师,走一个结构化的流程:理解 PRD,产出实现计划,产出技术规格,然后在规格被评审之前停下,不写任何代码。最后这条约束就是规格驱动开发的全部要点:它是刻意的检查点,不是工具碰巧这么实现的。
五、同一个想法,两种建法
现场那一小时只画了计划,没有在直播间里交付一个跑起来的服务。作为对照,作者给了同一个想法的更完整实现的架构,那份是另外单独搭的(用 Cursor 加双 LLM 的 coder/reviewer 流程,不是 Kiro)。拿它可以看出,一份规格做到位是什么样。
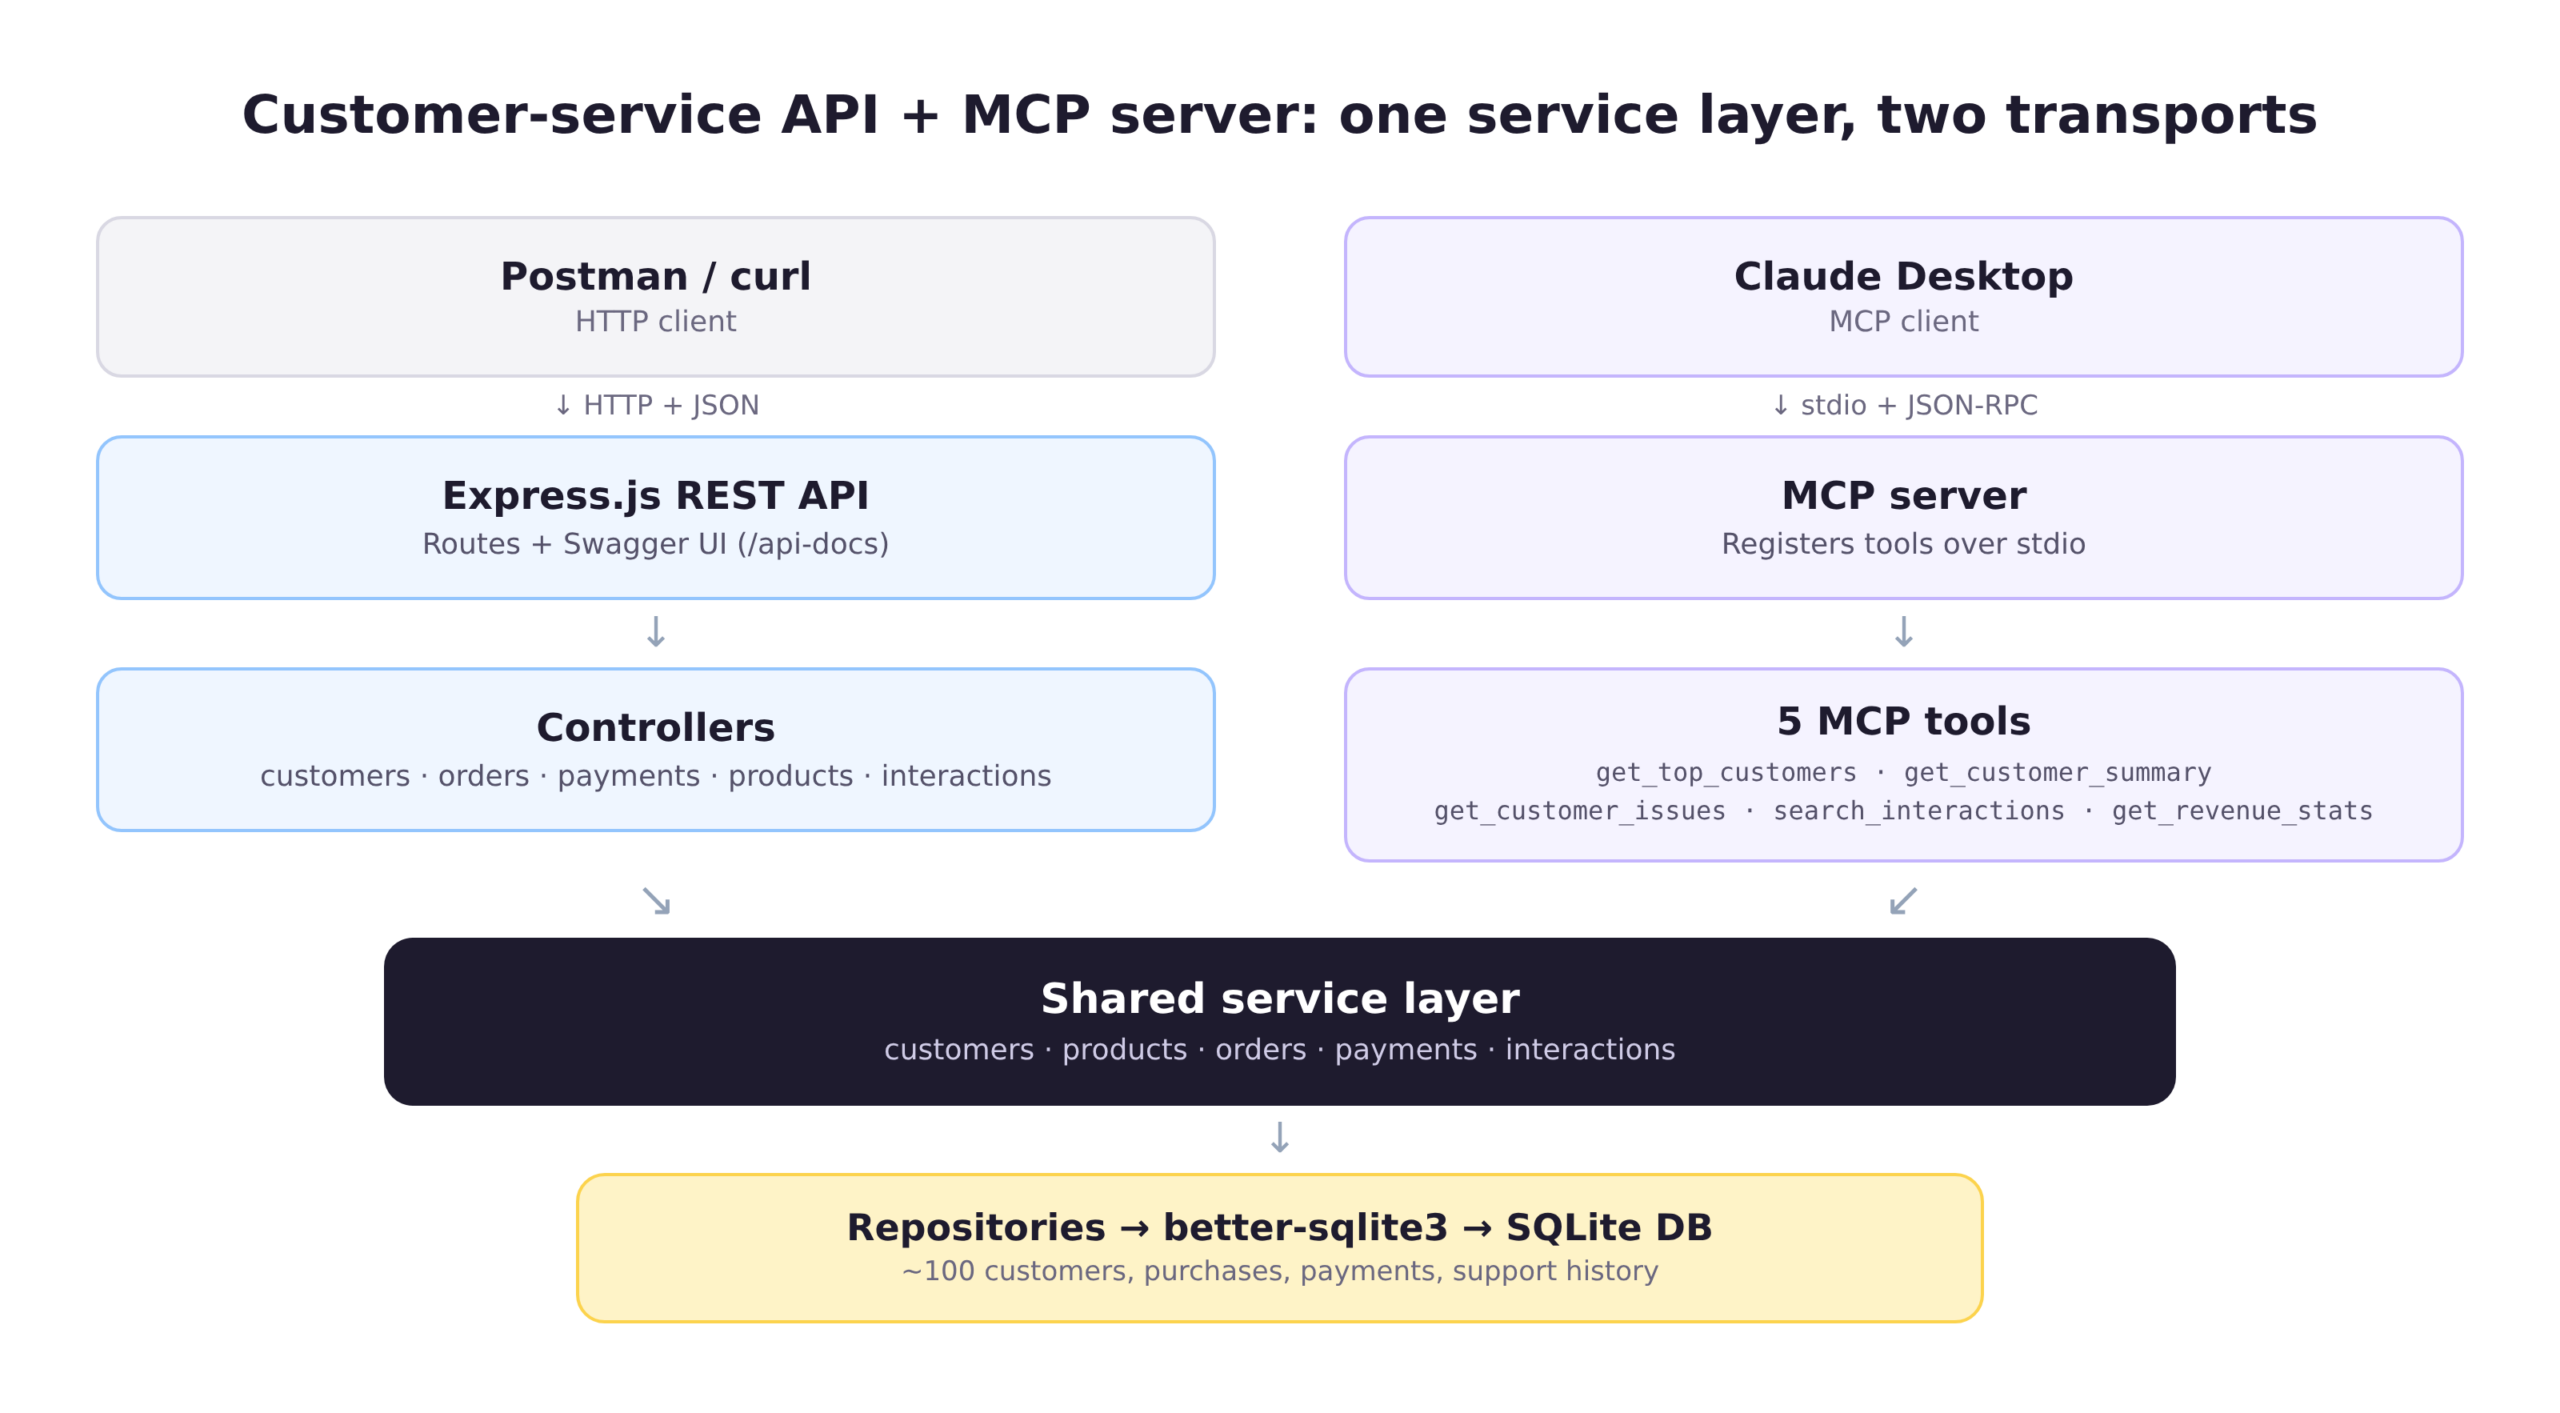
两个入口——REST API 和 MCP server——坐在同一套 service 与 repository 层上,共用一个 better-sqlite3 数据库。这正是 Kiro 的 design.md 那一步要逼你显式写下来的原则:一个数据/服务层,上面挂多个薄的传输层。
MCP server 暴露五个工具,全部由这个共享的 service 层支撑:
get_top_customers:花钱最多(或最活跃、或客服问题最多)的客户,带排名。get_customer_summary:单个客户的完整画像,订单、付款、交互历史。get_customer_issues:某个客户关联的工单和问题。search_interactions:在客服交互日志里做全文检索。get_revenue_stats:整个数据集的营收聚合指标。
实际效果是:这些够 Claude Desktop 画一张 top spenders 的柱状图,或者基于实时的 SQLite 数据推理「谁订单量最高、为什么」。这类问题本来要问 BI 看板,在这里变成五分钟的 MCP server,而不是一个报表项目。
六、Kiro 和自己拼一套:诚实的比较
两条路产出的是同一种三件套形状(需求 → 设计 → 任务),差别在于这个形状长在哪儿:
- Kiro:在一个 IDE 里用结构强制顺序,设了门禁,代码跑不到规格前面。
- 双 LLM 流程(Cursor 当 coder,第二个模型当 reviewer):靠流程和规则文件达到类似的纪律,但没有 IDE 级的门禁。设置成本更高,好处是与工具无关,也更容易贴合团队自己的风格。
没有「唯一正确的答案」。想让纪律被工具替你执行,Kiro 的上手更快;手上已经有不愿放弃的评审标准,手工流程更合适。
七、关于规格驱动开发,值得带走的几点
规格驱动开发不是 Kiro 专属的理念。它是 TDD 和 BDD 的哲学表亲:先问「我们要建的东西定义清楚了吗」,再问「代码通过测试了吗」。
过度工程化的陷阱是真的。让规格的份量匹配功能实际的风险,而不是匹配「理论上规格能写多细」。
MCP 恰好很适合这类内部工具的问题:把你已经信任的 service 层包起来,暴露少数几个命名清楚的工具,让聊天客户端去做查询。需要对非结构化数据做语义检索时,再配一个向量库。
最后一句话是作者说的:vibe coding 依然很适合探索。但只要 AI agent 写的是你以后要维护的代码,一份简短、经过评审的规格,就是你能买到的最便宜的保险。下一个小的功能,在 Kiro 里试试 Spec 模式,看看能替你省下多少返工。